

À combien revient un token : cinq chemins, les comptes et le point d'équilibre
La question qui revient toujours, avant d'acheter une GPU ou de souscrire une API : à combien revient vraiment un token, et d'où vient-il ? La réponse n'est pas une. Ce sont cinq chemins, avec des coûts, des plafonds et des dépendances très différents. On les met côte à côte, avec les chiffres du jour vérifiés sur les tarifs officiels, et on vous dit quand il vaut mieux louer ou posséder le matériel plutôt que d'appeler le frontier.
Le token, l'unité de compte
Chaque interaction avec un modèle se mesure en tokens : des morceaux de texte (mots coupés) en entrée et en sortie. Un million de tokens, c'est environ 750 000 mots : une conversation de quelques milliers de mots tient dans une poignée de milliers de tokens. Quiconque vous vend de l'intelligence — une API, un fournisseur, un serveur — le fait en tokens (ou, indirectement, en secondes de GPU qui produisent des tokens). Comprendre d'où vient le token et combien il vous coûte est tout l'enjeu, parce que le prix par token varie de plus d'un facteur cent selon le chemin.
Chemin 1 — Le modèle frontier en API
Vous appelez OpenAI ou Anthropic et vous recevez leur modèle le plus capable. C'est le plafond le plus haut qui existe aujourd'hui : pour le travail le plus dur, l'agent qui enchaîne, la synthèse complexe, les modèles frontier restent devant. Le prix est au token et reflète ce plafond. Les tarifs OpenAI du jour : la pointe de gamme GPT-6 Astra à 10 dollars le million de tokens en entrée et 50 en sortie ; l'intermédiaire GPT-5.6 Terra à 2 et 12 ; le volume GPT-5.6 Luna à 0,20 en entrée et 1,20 en sortie (vérifiés sur le tarif officiel). Anthropic suit la même logique avec ses modèles Claude.
Ce que vous obtenez : le meilleur, zéro installation, une montée en charge illimitée. Ce que vous payez en plus du prix : vos prompts et vos données traversent le réseau et arrivent sur le serveur du fournisseur ; la qualité et le prix peuvent changer quand le fournisseur le décide ; et si le service s'arrête, le vôtre s'arrête aussi.
Chemin 1b — L'abonnement, quand vous utilisez peu
À côté de l'API existe un second mode de paiement du frontier : l'abonnement mensuel à ChatGPT ou Claude. Plus coûte 20 dollars par mois, Pro 100 ou 200 selon le plafond d'usage (tarif officiel). La différence, c'est le modèle de coût :
| Abonnement (Plus) | API (GPT-6 Astra) | |
|---|---|---|
| Coût | 20 $/mois fixes | à la consommation, zéro si vous n'utilisez pas |
| Volume inclus | ~160 messages toutes les 3 heures | illimité, payé au token |
| 1 000 réponses/mois (~500 tokens chacune) | couvert par l'abonnement | ~21 $ (Astra) · ~5 $ (Terra) |
| 10 millions de tokens/mois | impossible (plafonds) | ~10–420 $ selon le modèle (Luna → Astra) |
Le compte est simple : une utilisation personnelle (des centaines de conversations par mois) reste confortablement sous les 20 dollars, alors que le même volume en API coûterait peu ou rien. Mais dès que le volume grossit — des centaines de milliers de tokens par jour, un service avec beaucoup d'utilisateurs — l'abonnement bute sur les plafonds et l'API redevient la seule voie. L'abonnement gagne sur l'usage léger, l'API sur l'usage lourd : ce ne sont pas deux offres du même produit, ce sont deux gammes de demande.
Chemin 2 — Les fournisseurs d'inférence
Même confort que l'API, mais sur des modèles ouverts : Replicate, Modal, RunPod serverless. Vous chargez un modèle open-weight (ou un modèle au choix de leur catalogue) et vous payez quand il tourne. Modal vous facture à la seconde : un H100 à 3,95 dollars l'heure, un A100 80 Go à 2,50 (tarif officiel). RunPod serverless suit la même logique avec des workers qui descendent à zéro quand ils ne servent à rien : une RTX 4090 en serverless à 1,10 l'heure.
L'avantage par rapport au frontier est double : souvent des modèles presque aussi bons pour un coût beaucoup plus bas, et des modèles ouverts que vous pouvez aussi télécharger et ramener chez vous. La limite, c'est que vous êtes encore en location : vous ne possédez rien, et la data passe tout de même par leur cloud.
Chemin 3 — Louer le matériel
Un cran en dessous : au lieu de demander des tokens, vous prenez vous-même le serveur. Sur RunPod et Vast.ai vous louez une GPU facturée à la minute : une RTX 4090 à 0,34–0,74 dollar l'heure selon le tier (community sans SLA ou secure avec SLA), une H100 à 2,00–3,99. Sur Vast.ai, la version interruptible coûte plus de 50 % de moins mais peut être récupérée à tout moment ; la version réservée verrouille des prix jusqu'à 50 % plus bas sur des contrats d'un, trois ou six mois (tarifs officiels).
Là, la nature du rapport change : le modèle est à vous, il tourne sur une machine que vous louez, et les données ne finissent pas dans une API d'intelligence. Vous payez seulement tant que le serveur tourne. Quand la charge est constante et grande, la location directe bat à la fois l'API frontier et le fournisseur d'inférence, parce que vous payez une GPU nue plutôt que de l'intelligence à valeur ajoutée.
Chemin 4 — Posséder le matériel
L'achat : une GPU (ou un Mac, ou un mini-PC), et c'est parti. Le coût est une fois pour toutes — une RTX 4090 de 24 Go se trouve autour de 1 600 euros, une 3090 d'occasion de 24 Go aux alentours de 1 000 — plus l'électricité pendant qu'elle tourne. Plus de token à payer, plus de minute à facturer : le modèle est là, toujours disponible, et aucune donnée de la vôtre ne quitte la maison ou l'entreprise.
C'est la seule voie où « toujours disponible » est littéralement vrai : elle ne dépend ni d'un réseau, ni d'un fournisseur, ni d'un prix qui peut changer. Et c'est la seule où la data ne part jamais.
Les chiffres, mis en rang
Un exemple concret : 20 millions de tokens par mois (un peu d'assistance client, un peu de synthèse), avec un mix réaliste de 4 millions en entrée et 16 millions en sortie. Le calcul : entrée ÷ 1 M × prix entrée + sortie ÷ 1 M × prix sortie (en euros, 1 $ = 0,92) :
| Voie | Calcul | Coût mensuel |
|---|---|---|
| API GPT-6 Astra | 4×10 + 16×50 | ~773 € |
| API GPT-5.6 Terra | 4×2 + 16×12 | ~184 € |
| API GPT-5.6 Luna | 4×0,20 + 16×1,20 | ~18 € |
| 4090 en location (secure), 24 h | 0,74 $/h × 730 h | ~497 € |
| 4090 en location (secure), 8 h/jour | 0,74 $/h × 244 h | ~166 € |
| 4090 à vous, 1 700 € | 1 700/36 mois + électricité | ~87 € |
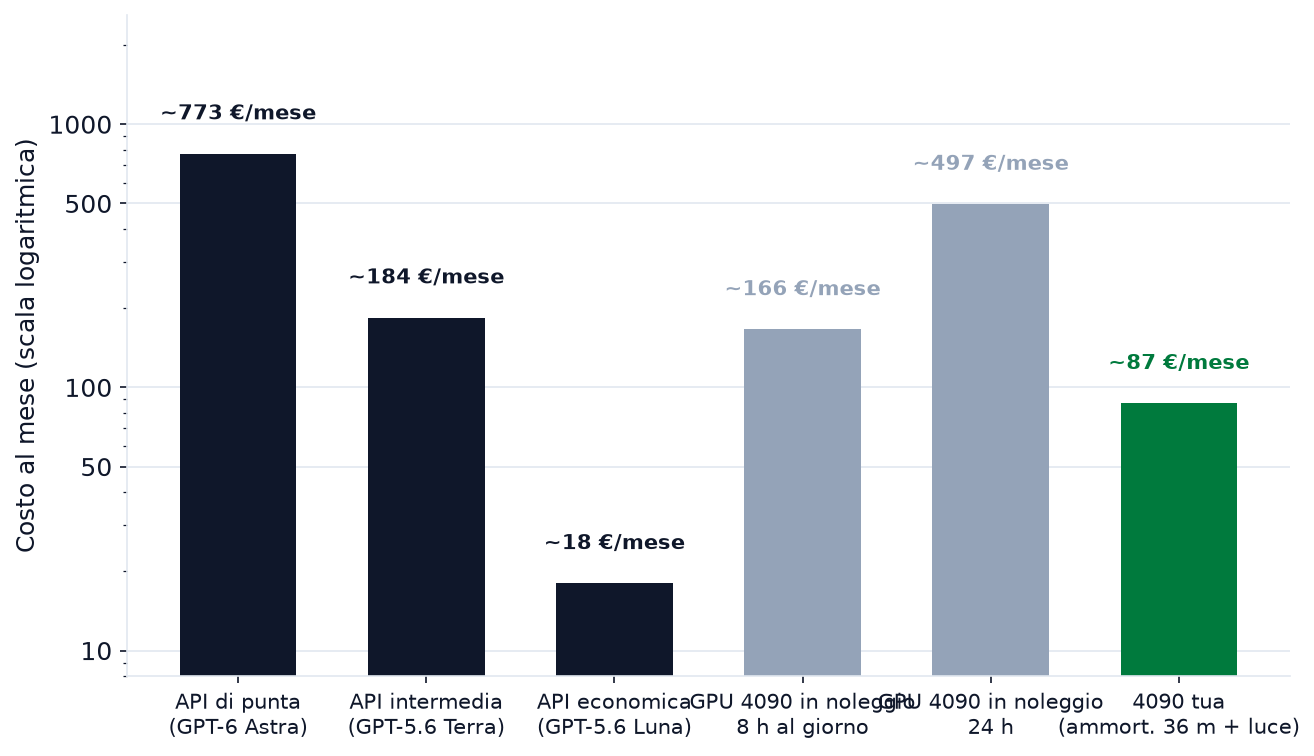
Le graphique dit la même chose que le tableau, seulement plus vite : pour exactement la même charge, le prix varie de 18 à 773 euros, un facteur 40. Ce n'est pas une erreur d'impression : vous achetez deux choses différentes, le plafond de qualité et le risque (le vôtre, ou celui du fournisseur).
Combien coûte vraiment l'électricité
La ligne la plus sous-estimée de la possession. Une machine avec une 4090 en charge de génération monte à 350–450 W, plus 100 W environ pour le reste du système (CPU, RAM, disques). Au repos avec le modèle chargé en mémoire, 80–100 W. Le compte par mois, à 0,25 euro/kWh (tarif de base moyen) :
- 8 heures par jour de travail (122 kWh en charge + 100 au repos → 158 kWh) : ~40 €/mois
- 18 heures par jour (282 + 58 kWh → 265 kWh) : ~66 €/mois
- 24 h sur 24 : 329 kWh → ~82 €/mois
La formule à retenir : watts ÷ 1000 × heures × tarif, heures de charge comprises. À 0,30 €/kWh (tarif plus élevé), multipliez par 1,2. Deux notes : la machine consomme même quand elle ne génère pas (c'est pourquoi le repos avec le modèle chargé compte), et un Mac à mémoire unifiée consomme dix fois moins (30 W au total au lieu de 450), donc la ligne électricité sur un Mac est en pratique négligeable.
Le ROI du matériel : quand il se rembourse
Misons en file les coûts cumulés sur 36 mois. Scénario : 4090 à 1 600 € + 100 € d'accessoires (1 700 € au total), amortissement sur 36 mois, électricité à 40 €/mois (usage quotidien, 8 heures par jour).
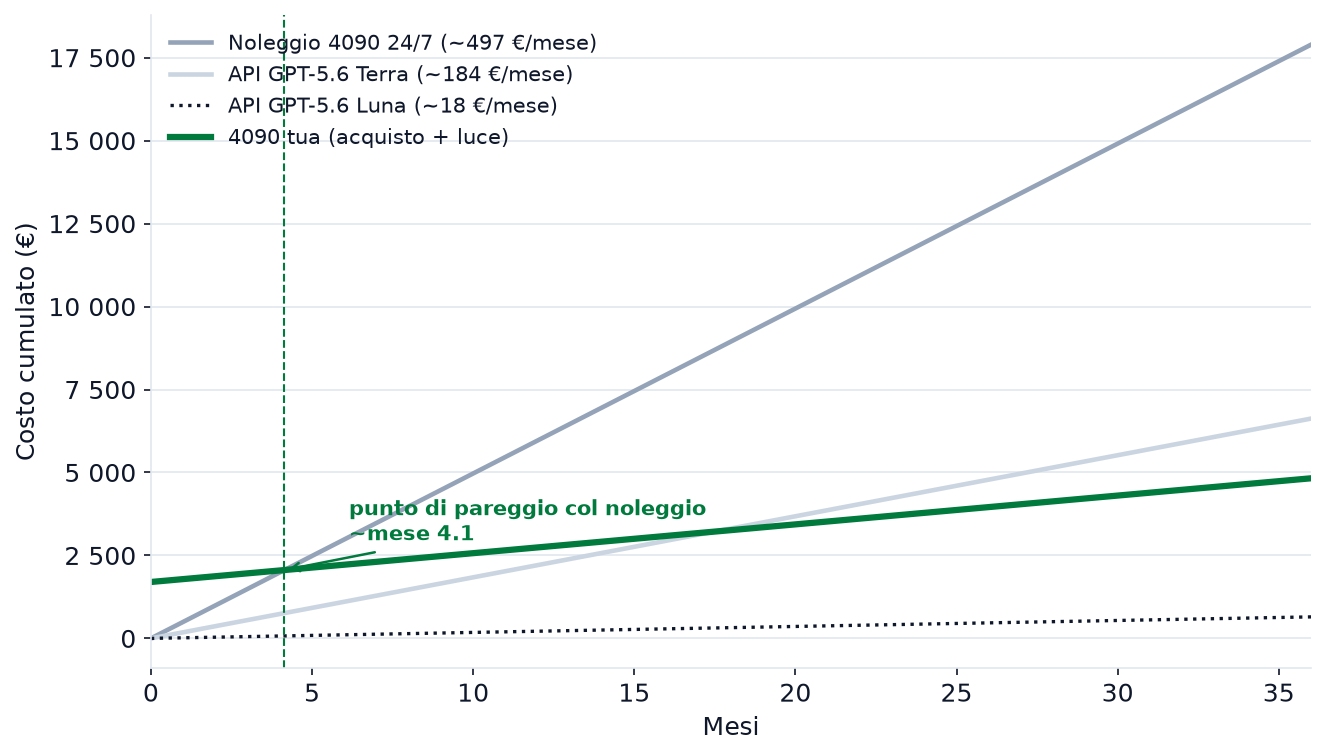
- Mois 1 : matériel ~1 790 €, location 24/7 ~497 €, API Terra ~184 €, API Luna ~18 €. Pendant les trois premiers mois, l'API reste la voie la moins chère.
- Vers le mois 4 : le point d'équilibre avec la location 24/7 (497 €/mois contre 87 €/mois + 1 700 € d'entrée). Dès lors, la courbe de l'achat est la plus basse parmi les voies à modèle ouvert, et l'écart s'élargit mois après mois.
- Mois 36 : matériel ~4 825 € au total contre 17 892 € de location continue, 6 624 € d'API Terra, 27 828 € d'API Astra.
Le point d'équilibre se calcule avec votre charge : location (€/h × heures/mois) contre amortissement (prix ÷ mois) + électricité. Si le serveur tourne plus de 5–6 mois, à parité de modèle l'achat gagne presque toujours ; si la charge est intermittente, la location ou l'API économique restent devant. Et il y a la variable qualité : si votre travail exige vraiment la pointe frontier, le matériel grand public n'est pas une alternative, c'est un autre outil — et la manœuvre économique, c'est le mix : 90 % du volume sur le modèle ouvert, 10 % sur le frontier.
Où la location et la possession gagnent
Trois signaux qui disent « arrêtez de payer le frontier » : votre charge est constante (le serveur tourne beaucoup, la location directe ou la possession battent la facturation à valeur ajoutée) ; le modèle qui vous suffit est ouvert (à ce point, vous ne payez que le confort que vous pourriez retirer) ; et les données doivent rester les vôtres (alors seule la possession — et, en second, la location — vous va). Dans ces trois cas, la location et le matériel propre ne sont pas le plan B : ce sont le plan qui coûte moins et vous garde le contrôle en main.
Comment choisir
- Usage léger, personnel : l'abonnement — 20 $ par mois couvrent des centaines de conversations.
- Tests, prototypes, charges irrégulières : API ou fournisseur d'inférence — vous partez de coûts fixes nuls.
- Charge constante, modèle ouvert, budget à tenir quelques mois : louez la GPU directe.
- Charge constante plus de six mois, données sensibles, disponibilité 24/7 : achetez. C'est la seule voie sans dépendances.
- Le travail le plus dur qui n'existe que dans le frontier : payez-le — mais seulement ce morceau, pas le reste.
La plupart des charges réelles sont un mélange. Le geste qui fait économiser, c'est de les décomposer : 90 % du volume sur le modèle ouvert (loué ou possédé), 10 % du vrai travail sur le frontier. Dans ce mélange, le token qui compte le plus — celui qui produit de la valeur — vient du matériel que vous contrôlez. Pour dimensionner votre charge sur votre matériel avant de décider, partez du Planificateur de setup.
Sources
- Prix OpenAI (GPT-6, GPT-5.6) — tarif officiel
- Prix ChatGPT (Free, Go, Plus, Pro, Business) — tarif officiel
- Prix Anthropic
- Prix Modal (GPU à la seconde)
- Prix RunPod (community, secure, serverless)
- Prix Vast.ai (on-demand, interruptible, reserved)
- Comparatif des prix GPU cloud 2026
- Consommation réelle RTX 4090 sous charge d'inférence
- Coûts du matériel local
Article généré par IA
Dans ces parcours
Vous avez aimé cet article ?
Abonnez-vous à la newsletter pour recevoir de nouveaux tutoriels et guides.